Você já se perguntou como os bancos conseguem prever quais clientes têm maior risco de inadimplência? Ou como uma instituição financeira decide ajustar limites de crédito com base no comportamento dos usuários?
A resposta está em um processo chamado KDD – Knowledge Discovery in Databases, ou Descoberta de Conhecimento em Bases de Dados. Embora o nome pareça técnico, o conceito é mais acessível do que parece — e extremamente útil para quem trabalha com dados, finanças ou gestão de processos.
Neste post, vamos explorar os 14 fundamentos essenciais do KDD, conectando cada etapa a exemplos reais do setor financeiro. A ideia é mostrar como os dados, quando bem tratados e analisados, podem se transformar em conhecimento valioso para tomada de decisão.
Você vai entender desde a importância da seleção e preparação dos dados, passando por algoritmos de aprendizagem de máquina, até chegar à interpretação dos resultados e sua aplicação prática – tudo isso com uma linguagem clara e visual.
Se você atua como analista, gestor ou está apenas começando a se aventurar no mundo da ciência de dados, este conteúdo é para você.
1. Dados
Os dados são a matéria-prima da descoberta de conhecimento. Eles representam informações sobre entidades como clientes, transações, produtos ou eventos.
Exemplo financeiro: Uma instituição bancária coleta dados sobre clientes, como idade, renda, histórico de crédito e comportamento de pagamento.
2. Analista e Especialista do Domínio
O analista de dados é quem conduz o processo técnico de KDD. Já o especialista do domínio (por exemplo, um gerente de crédito) fornece o conhecimento prático sobre o negócio.
Exemplo: O analista estrutura os dados e aplica algoritmos, enquanto o especialista define que o objetivo é prever inadimplência.
3. Processo de KDD
O KDD (Knowledge Discovery in Databases) é composto por várias etapas:
A – Definição do problema: envolve o conjunto de dados, o especialista do domínio e os objetivos da aplicação.
B- Pré-processamento: inclui seleção, limpeza, codificação e enriquecimento dos dados.
C- Mineração de dados: aplicação de algoritmos para extrair padrões; técnicas: redes neurais, algoritmos genéticos, estatística, lógica nebulosa; tarefas: classificação, regressão, agrupamento, detecção de desvios, descoberta de associações.
D- Pós-processamento: avaliação e organização dos resultados para facilitar a interpretação.
E- Interpretação dos resultados
Exemplo: Um banco quer identificar padrões de clientes que têm maior risco de inadimplência. O KDD ajuda a transformar dados brutos em modelos preditivos úteis.
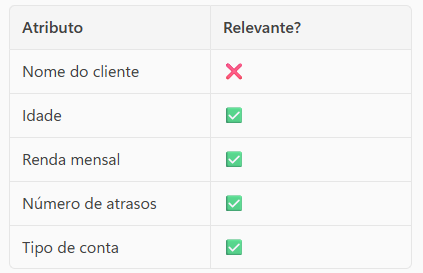
4. Seleção de Dados
Consiste em escolher os atributos e registros relevantes para análise.
Exemplo: Para prever inadimplência, atributos como nome do cliente podem ser irrelevantes, enquanto idade e histórico de crédito são essenciais.
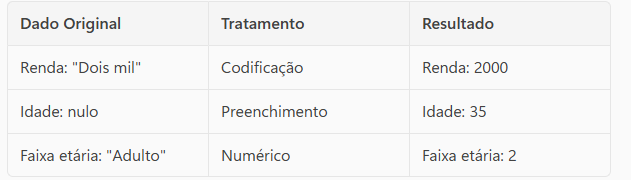
5. Transformação e Pré-processamento
Inclui limpeza, codificação e enriquecimento dos dados.
- Limpeza: Corrigir dados faltantes ou inconsistentes.
- Codificação: Transformar dados categóricos em numéricos.
- Enriquecimento: Adicionar dados externos úteis.
Exemplo: Renda negativa é removida; “faixa etária” é transformada em números; dados de crédito externo são incorporados.
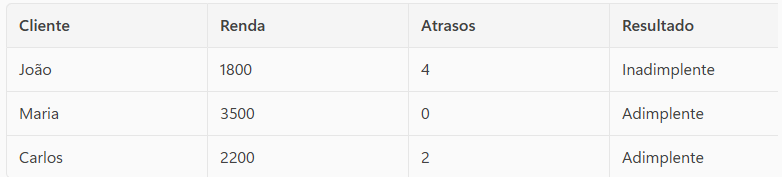
6. Aprendizagem de Máquina
É a etapa de mineração de dados, onde algoritmos são aplicados para extrair padrões e construir modelos.
Exemplo: Um modelo de classificação é treinado para prever se um cliente será adimplente ou inadimplente com base em seu perfil.
7. Conjunto de Treino, Teste e Validação
- Treino: Dados usados para ensinar o modelo.
- Teste: Dados para avaliar o desempenho.
- Validação: Verifica se o modelo generaliza bem.
Exemplo: O banco usa dados históricos de clientes para treinar o modelo e depois testa com dados recentes para validar sua eficácia.
8. Interpretação e Pós-processamento
Transforma os resultados em conhecimento compreensível e útil para tomada de decisão.
Exemplo: O modelo gera uma regra: “clientes com renda < R$2.000 e mais de 3 atrasos têm 80% de chance de inadimplência”.
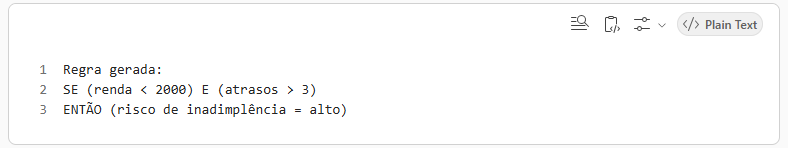
9. Papel do Usuário e do Especialista em KDD
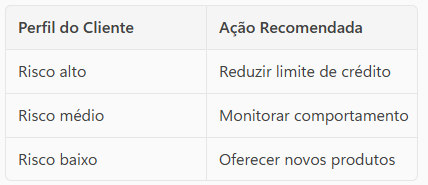
O usuário (como um gerente financeiro) interpreta os resultados e toma decisões. O especialista em KDD conduz o processo técnico.
Exemplo: O gerente decide ajustar políticas de crédito com base nas regras geradas pelo modelo.
10. Big Data
Refere-se ao grande volume, variedade e velocidade dos dados gerados.
Exemplo: Um banco coleta milhões de transações por dia, incluindo dados de cartão, transferências e interações em aplicativos.
11. Tipos de Dados
- Gerados por humanos: Formulários preenchidos, interações em apps.
- Mediados por processos: Dados de sistemas ERP, CRM.
- Gerados por máquinas: Logs de servidores, sensores, dispositivos IoT.
Exemplo: Dados de compras feitas por clientes (humanos), processadas por sistemas bancários (mediados), e registradas por servidores (máquinas).
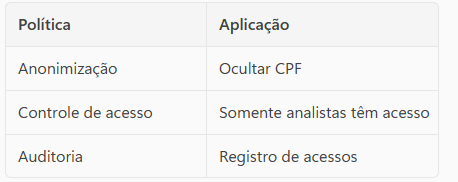
12. Governança de Dados
Envolve políticas para garantir qualidade, segurança e conformidade dos dados.
Exemplo: O banco define regras para anonimização de dados de clientes e controle de acesso aos dados sensíveis.
13. Ambiente de Simulação
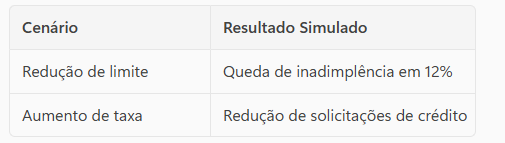
Usado para testar modelos em cenários hipotéticos antes da aplicação real.
Exemplo: Simular o impacto de uma nova política de crédito sobre a taxa de inadimplência.
14. Ambiente de Desenvolvimento
Local onde os modelos são criados, testados e ajustados.
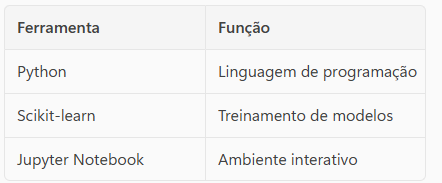
Exemplo: O analista usa Python e bibliotecas como Scikit-learn em um ambiente de desenvolvimento para construir o modelo preditivo.
A descoberta de conhecimento em bases de dados (KDD) pode parecer complexa à primeira vista, mas como vimos ao longo deste post, ela é composta por etapas bem definidas — e quando aplicadas ao setor financeiro, revelam um enorme potencial para transformar dados em decisões estratégicas.
Ao entender como selecionar, preparar, analisar e interpretar os dados, profissionais da área financeira ganham uma vantagem competitiva: conseguem antecipar riscos, identificar oportunidades e tomar decisões mais embasadas.
Se você está começando a explorar esse universo ou já atua com dados e quer aprimorar sua prática, vale a pena revisitar cada uma das 14 etapas apresentadas aqui e pensar em como elas se aplicam ao seu contexto.
E lembre-se: mais importante do que dominar ferramentas é compreender o processo e saber fazer as perguntas certas. Afinal, é isso que transforma dados em conhecimento – e conhecimento em ação.
Fundamentação teórica: GOLDSCHMIDT, R. R. et al. Data Mining – Conceitos, técnicas, algoritmos, orientações e aplicações. 2. ed. Rio de Janeiro: GEN LTC, 2015.
Link do Livro: https://www.amazon.com.br/Data-Mining-Ronaldo-Goldschmidt-ebook/dp/B00YEWR08U
 Y-DATAFIN

Deixe um comentário